万兆网卡与阵列卡搭配方案:企业级服务器存储性能优化实践
企业级存储服务器的性能瓶颈,往往不在CPU或内存,而在于数据从磁盘到网络这条链路的协同效率。很多运维团队在升级时只盯着万兆网卡的带宽参数,却忽略了后端阵列卡与HBA卡的匹配关系,结果花了钱却跑不出预期IOPS。下面结合实际部署经验,拆解这套搭配方案的技术逻辑。
数据通路上的三个关键节点
一台典型的企业级存储服务器,数据流向大致是:磁盘阵列 → 阵列卡(或直连HBA卡)→ PCIe总线 → 万兆网卡 → 交换机。每个节点的吞吐上限和队列深度都会影响最终表现。阵列卡负责RAID运算与缓存调度,带缓存和超级电容的型号能显著降低写惩罚;HBA卡则适合JBOD直通场景,把RAID逻辑交给上层软件定义存储。而光纤网卡在多路径冗余和低延迟场景中,比电口万兆更具优势,尤其在iSCSI或NVMe-oF部署中。
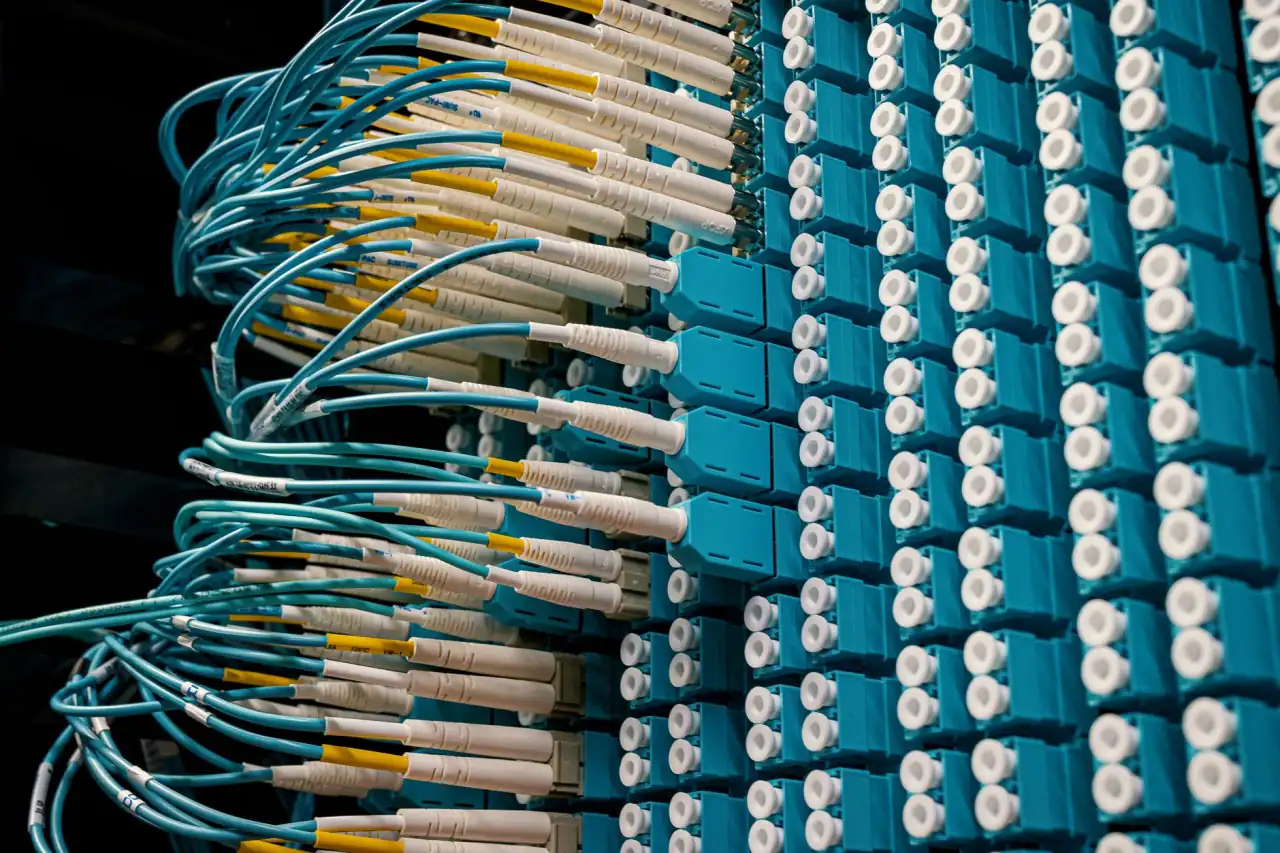
容易被忽视的是网卡模块——SFP+光模块的兼容性和散热直接影响链路稳定性。曾遇到某批次第三方模块在满载时误码率飙升,更换原厂模块后问题消失。
搭配方案与实操要点
根据业务类型,可参考以下组合思路:
- 高IOPS数据库场景:阵列卡(带1GB以上缓存)+ RAID10 + 双口万兆网卡,队列深度调至256以上
- 大容量归档场景:HBA卡直通 + 软件RAID + 单口光纤网卡,侧重顺序带宽
- 虚拟化宿主机:阵列卡RAID5/6 + 双口万兆绑定(LACP),网卡模块选用10G SR多模
实操中建议先确认PCIe代际与通道分配:万兆网卡插在PCIe 3.0 x8插槽即可跑满,但若与阵列卡共享PCH通道,可能产生争用。BIOS中开启Above 4G Decoding,避免大缓存阵列卡地址映射冲突。
一组实测数据对比
在相同磁盘配置(8块SAS SSD)下测试:阵列卡RAID10搭配双口万兆,顺序读约1.9GB/s,4K随机读约28万IOPS;换成HBA直通+软件RAID后,顺序读略升至2.1GB/s,但随机读降至19万IOPS。可见硬件阵列卡在随机小IO场景仍有明显优势,而光纤网卡的低延迟特性在iSCSI块存储中比电口方案平均响应时间低约15%。
选型没有万能公式,关键是让万兆网卡、阵列卡、HBA卡与网卡模块在带宽、队列和协议层面形成闭环。海口瑄瑜烨网络科技有限公司在产品中心提供多档搭配方案,可根据实际负载做针对性匹配。